Информатика. ЕГЭ
Задание 27. Информатика. ЕГЭ 2026. Апробация. 14.05.2026
- Просмотры: 2672
- Изменено: 16 мая 2026
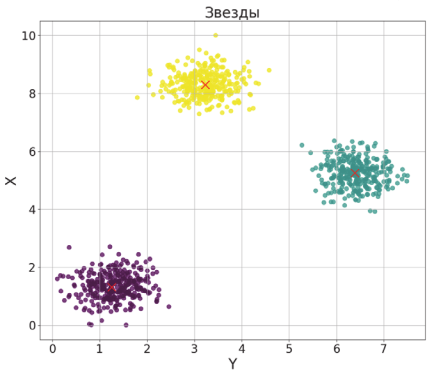
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на \(N\) непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной \(H\) и \(W,\) причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям.
Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости \(A(x_1,~y_1)\) и \(B(x_2,~y_2)\) вычисляется по формуле: $$d(A, \, B) = \sqrt{(x_2 - x_1)^2 + (y_2 - y_1)^2}$$
В файле А хранятся данные о звёздах двух кластеров, где \(H = 6{,}5,\) \(W = 4{,}5\) для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата \(x,\) затем координата \(y.\) Значения даны в условных единицах. Известно, что количество звёзд не превышает \(1000.\)
В файле В хранятся данные о звёздах трёх кластеров, где \(H = 6{,}5,\) \(W = 4{,}5\) для каждого кластера. Известно, что количество звёзд не превышает \(10~000.\) Структура хранения информации о звездах в файле В аналогична файлу А.
Для файла А определите координаты центра каждого кластера, затем найдите два числа: \(A_1\) — в кластере с наименьшим количеством точек число точек, абсцисса которых не больше абсциссы центра этого кластера, и \(A_2\) — расстояние между центрами кластеров.
Для файла B определите координаты центра каждого кластера, затем найдите два числа: \(B_1\) — в среднем по количеству точек кластере число точек, находящихся внутри квадрата с центром в центре этого же кластера, сторонами, параллельными координатным осям и длиной \(2{,}0,\) и \(B_2\) — расстояние по оси ординат между центрами кластеров с наименьшим и наибольшим количеством точек.
Гарантируется, что во всех кластерах количество точек различно.
В ответе запишите четыре числа: в первой строке — сначала \(A_1,\) затем целую часть произведения \(A_2 \times 10~000;\) во второй строке — сначала \(B_1,\) затем целую часть произведения \(B_2 \times 10~000.\)
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемого файла.
Решение:
Python
from math import dist

base = ''
files = ('27_A.txt', '27_B.txt')
eps = 1

for t in (0, 1):
    data = [tuple(map(float, line.replace(',', '.').split())) for line in open(base + files[t])]
    clusters = []
    while data:
        clusters.append([data.pop()])
        for p in clusters[-1]:
            neigh = [pt for pt in data if dist(p, pt) < eps]
            clusters[-1] += neigh
            for pt in neigh:
                data.remove(pt)
    clusters.sort(key=len)
    # print(len(clusters), [len(c) for c in clusters])
    centers = []
    for cl in clusters:
        dmin = float('inf')
        c = None
        for p in cl:
            d = sum(dist(p, pt) for pt in cl)
            if d < dmin:
                dmin = d
                c = p
        centers.append(c)
    if t == 0:
        A1 = sum(p[0] <= centers[0][0] for p in clusters[0])
        A2 = dist(centers[0], centers[1])
        print(A1, int(A2 * 10_000))
    else:
        B1 = sum(abs(p[0] - centers[1][0]) < 1 and abs(p[1] - centers[1][1]) < 1 for p in clusters[1])
        B2 = abs(centers[0][1] - centers[2][1])
        print(B1, int(B2 * 10_000))
Ответ:
\(141 \,\, 129966\)
\(132 \,\, 127070\)
Новый тренажёр-эмулятор
Станции КЕГЭ
Эффективно готовьтесь к ЕГЭ по информатике с новым тренажёром, эмулирующем работу станции КЕГЭ, которая используется на реальном экзамене
Новое видео
Поддержать автора сайта!
Расписание пробников Статграда в 2026/27 учебном году
Информатика ОГЭ 9 класс
- 13 октября 2026 года
- 3 декабря 2026 года
- 21 января 2027 года
- 19 февраля 2027 года
- 23 марта 2027 года
- 27 апреля 2027 года
Математика ОГЭ 9 класс
- 23 сентября 2026 года
- 1 декабря 2026 года
- 22 января 2027 года
- 3 марта 2027 года
- 14 апреля 2027 года
Физика ОГЭ 9 класс
- 19 октября 2026 года
- 10 декабря 2026 года
- 29 января 2027 года
- 17 марта 2027 года
- 22 апреля 2027 года
Математика ЕГЭ 10 класс
- 3 февраля 2027 года
- 11 мая 2027 года
Информатика ЕГЭ 11 класс
- 22 октября 2026 года
- 15 декабря 2026 года
- 26 января 2027 года
- 2 марта 2027 года
- 13 апреля 2027 года
Математика ЕГЭ 11 класс
- 30 сентября 2026 года
- 17 декабря 2026 года
- 9 февраля 2027 года
- 16 марта 2027 года
- 21 апреля 2027 года
Физика ЕГЭ 11 класс
- 14 октября 2026 года
- 16 декабря 2026 года
- 4 февраля 2027 года
- 12 марта 2027 года
- 9 апреля 2027 года